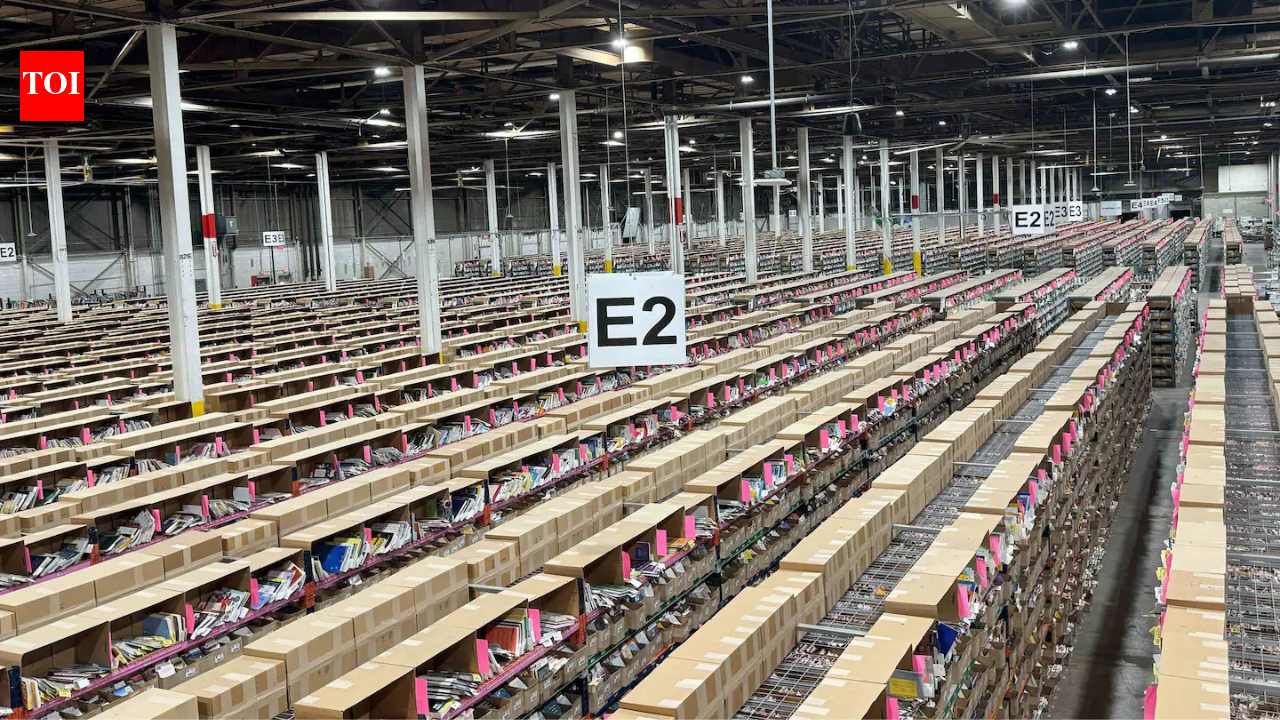
La información sigue reglas simples: cuanto más la usas, más cambia de forma y la comparte con otros. La mente humana crece asimilando, sintetizando y remodelando conocimientos. De la historia oral a la escritura, de las cartas a los libros, de las computadoras a los algoritmos, cada etapa del progreso depende de preservar y luego reelaborar lo que vino antes. La inteligencia artificial se basa en el mismo principio. Los sistemas diseñados para proporcionar respuestas a todo, en todas partes y al mismo tiempo requieren acceso a los registros más amplios y fiables del pensamiento humano.Durante siglos, los libros han sido la forma de información más fiable y duradera. Desde herramientas antiguas y supervivencia hasta cohetes y Marte, cartas escritas a mano, redes digitales y desde buscar comida hasta pedir la cena en minutos, el libro traza el largo arco de la humanidad. Mantienen sus ideas de generación en generación. Dentro de Anthropic, los planificadores veían los libros como una forma central de conocimiento humano, dependiendo de los editores, los autores y el tiempo. Creían que los textos extensos podrían enseñar a la IA a escribir de manera más clara y comprensible que el contenido en línea fragmentado.Esta creencia llevó a un esfuerzo interno conocido más tarde como el Proyecto Panamá. Los documentos judiciales que revelan reclamaciones de derechos de autor muestran cómo funcionó. Anthropic compró libros de física al por mayor. Los libros se separan y escanean a alta velocidad. Después de la digitalización, se reciclaron las copias en papel. El objetivo era aumentar rápidamente la cantidad de datos basados en libros utilizados para entrenar los sistemas de inteligencia artificial de la empresa. La escala del proyecto fue revelada en un informe de The Washington Post sobre cómo las empresas de inteligencia artificial han buscado agresivamente textos de alta calidad en medio de una carrera cada vez más intensa para construir chatbots más capaces.Los documentos internos muestran que la empresa optó por este enfoque en lugar de negociar una licencia. Los ejecutivos argumentaron que era más rápido y práctico comprar copias físicas y digitalizarlas internamente. Esta estrategia refleja la competencia cada vez más feroz por el dominio de la IA, y cada avance impacta directamente en la participación de mercado, la inversión y los ingresos. En una industria que avanza rápidamente y con nuevos desarrollos casi a diario, el acceso a datos de alta calidad se ha convertido en uno de los activos más valiosos para convertir el potencial de la IA en poder comercial.
como proyecto Panamá Se produjeron millones de libros.
Una propuesta de un proveedor y documentos judiciales indican que Anthropic tiene capacidad para escanear entre 500.000 y 2 millones de libros en aproximadamente seis meses. Aunque se desconoce la cifra final, las declaraciones juradas describen repetidamente la compra y destrucción de millones de volúmenes obtenidos en decenas de miles de lotes. El proyecto gastó decenas de millones de dólares en libros, logística y servicios de escaneo, destacando cómo los libros se centraban en estrategias de aprendizaje de IA.Después de la compra, los libros se envían a proveedores comerciales para la documentación de producción. Las máquinas de corte hidráulicas retiran el lomo y permiten escanear la hoja en equipos de producción de alta velocidad. Después de la digitalización, está previsto reciclar las copias en papel. El proceso fue deliberadamente irreversible y no dejó ningún archivo físico. Los expertos en conservación señalan que esto distingue al Proyecto Panamá de esfuerzos de digitalización anteriores donde se preservaron los originales.Según registros judiciales, Anthropic considera que el escaneo destructivo es una alternativa más segura a la descarga de bibliotecas digitales de robo masivo. El enfoque se basa en las lecciones aprendidas de varios esfuerzos de digitalización anteriores, incluido Google Books, y fue desarrollado en parte por Tom Turvey, quien trabajó en este proyecto. Sin embargo, a diferencia de Google Books, el Proyecto Panamá priorizó la velocidad y la exclusividad sobre el acceso y almacenamiento públicos.Posteriormente, un juez federal dictaminó que entrenar modelos de IA en libros califica como uso legítimo si el proceso cambia. Sin embargo, el tribunal dictaminó que las descargas anteriores de libros pirateados por parte de Anthropic plantearon un problema de derechos de autor separado, dejando claro que incluso si el curso en sí estuviera autorizado, la forma en que se obtuvo el material del curso todavía tenía importancia legal.
Respuesta y cálculo del autor.
Los autores reaccionaron fuertemente a este informe, argumentando que las empresas de IA se benefician del trabajo creativo sin permiso ni compensación. El ex director ejecutivo de IA, Ed Newton-Rex, dijo que el caso pone de relieve un creciente desequilibrio entre las empresas de tecnología y los creadores que sustentan los sistemas modernos de IA. Él y otros argumentan que el sistema de derechos de autor existente no aborda adecuadamente el aprendizaje automático a gran escala.En 2025, Anthropic acordó pagar 1.500 millones de dólares para resolver reclamaciones relacionadas con el uso anterior de libros plagiados y admitió haber cometido irregularidades. Los escritores cuyas obras estén incluidas en el acuerdo pueden recibir una compensación de alrededor de 3.000 dólares por obra, pero la cantidad varía. Según Anthropic, el acuerdo abordó prácticas de adquisición más que la legalidad del entrenamiento en inteligencia artificial.
Parte de un modelo industrial más amplio
El Proyecto Panamá no es un caso aislado. Otras demandas muestran que los empleados de Meta cuestionaron la descarga de grandes bibliotecas ocultas, mientras que OpenAI admitió anteriormente haber descargado conjuntos de datos similares antes de eliminarlos. Google y Microsoft enfrentan desafíos legales por los datos de entrenamiento de IA.El experto en derecho James Grimmelmann dice que la industria ha convertido las normas de uso de datos académicos en una carrera armamentista comercial, y solo enfrenta riesgos legales después de que se han realizado grandes inversiones. En ese momento, señaló, las empresas estaban efectivamente atrapadas en canales de información que serían difíciles de desenredar.Los registros abiertos que rodean el Proyecto Panamá ofrecen la visión más clara hasta ahora de cómo se construyen los sistemas modernos de inteligencia artificial. Muestran que detrás de los chatbots orientados al consumidor hay un proceso de producción que implica importantes gastos de capital, riesgos legales y extracción de datos irreversible. El caso ha alimentado el debate sobre si la actual ley de derechos de autor está equipada para regular ampliamente el aprendizaje automático.Mientras los tribunales continúan definiendo límites de uso legítimo para la capacitación en inteligencia artificial, el Proyecto Panamá es un claro ejemplo de las presiones que dan forma al desarrollo de la IA, la tensión no resuelta entre el progreso tecnológico y los derechos de los creadores.


